Texto na ordem de leitura
Linhas reconhecidas com posição e grau de confiança de cada bloco.
Notas fiscais, boletos, contratos e comprovantes passam por um pipeline visual de quatro estágios. O resultado sai conferido contra os seus sistemas, pronto para o próximo robô ou agente.
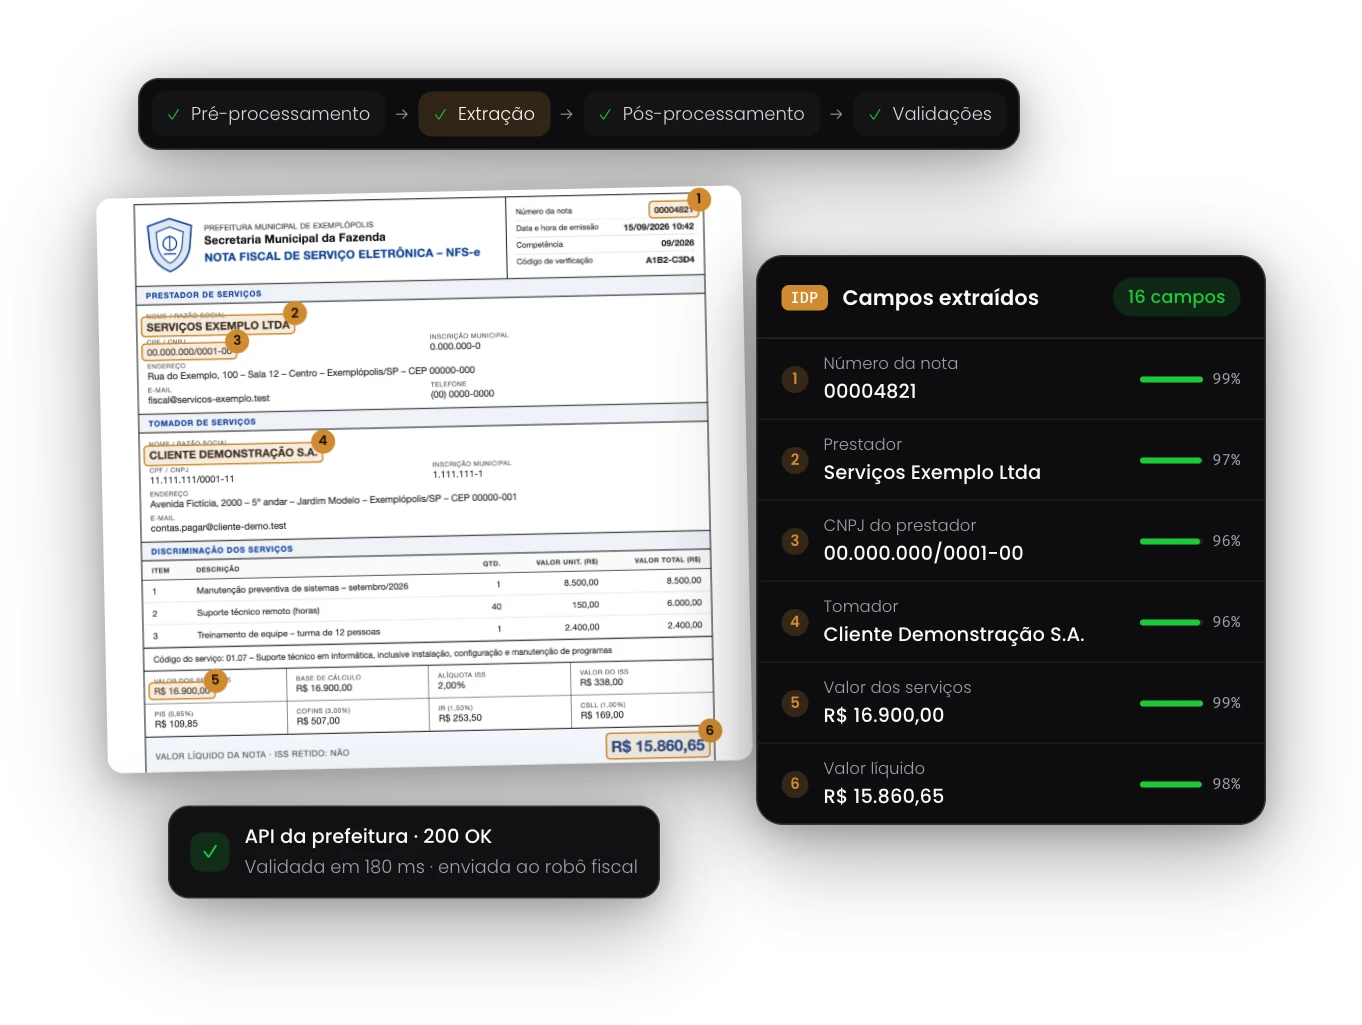
Cada estágio tem camadas que podem ser ligadas, desligadas e reordenadas. Etapas desativadas continuam registradas no resultado.
Filtros de imagem aplicados em ordem, com prévia de cada etapa.
O método certo para cada tipo de documento.
O texto extraído vira o dado que o seu sistema espera.
O resultado é conferido antes de seguir adiante.
OCR em nuvem, OCR open source e OCR por modelo de visão, escolhidos por template conforme o documento.
Linhas reconhecidas com posição e grau de confiança de cada bloco.
Linhas e colunas reconstruídas em formato tabular, prontas para consumo.
Pares chave-valor, incluindo o estado de caixas de seleção.
PDF e TIFF processados página a página. Também PNG, JPG, WEBP, GIF e BMP.
Descreva em um prompt como o conteúdo deve ser normalizado e classificado, ou escreva um script. Nos dois runtimes o contrato é o mesmo: o script lê input e devolve output.
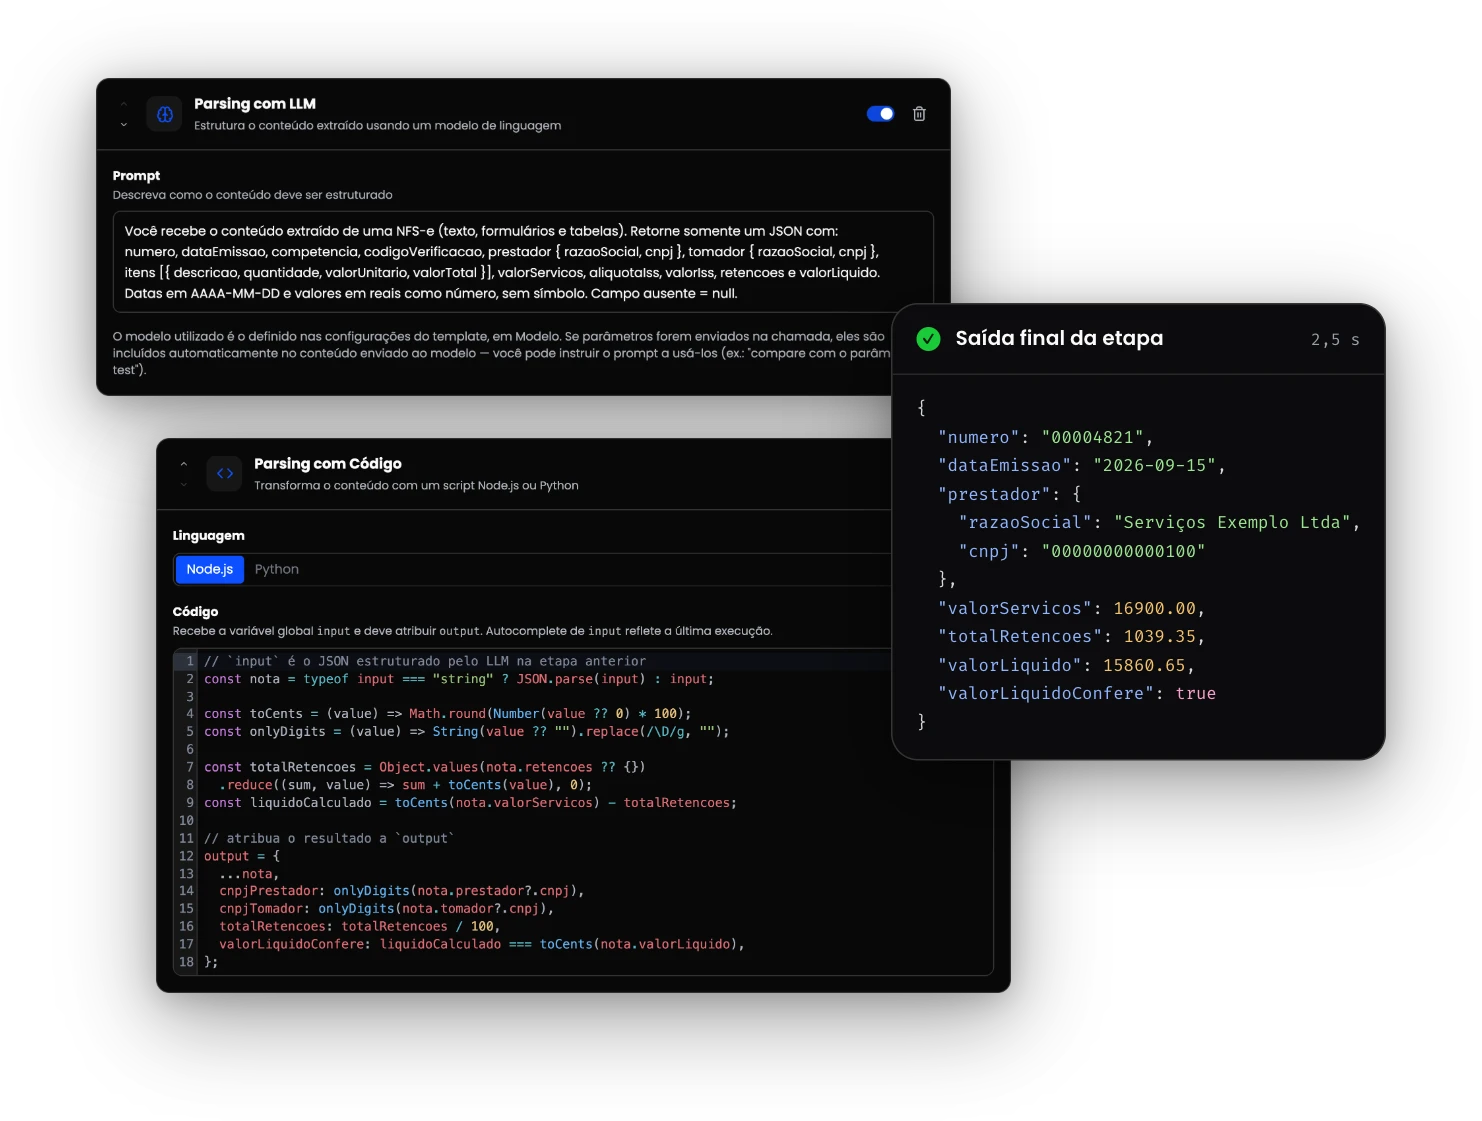
Valide o resultado contra APIs institucionais ou entregue direto para um robô de RPA, integrando documento e automação no mesmo ciclo de trabalho.
Teste, publique, meça e volte atrás com o mesmo rigor.
Rode o pipeline sobre o documento de referência ou sobre um arquivo avulso, estágio por estágio.
Publicação semântica com snapshot completo do template, ativação controlada e rollback.
Campos esperados e expectativa de sucesso ou falha, executados em lote a cada mudança.
Cada filtro, método de extração, camada e validação cronometrados em toda execução.
Execuções de produção, desenvolvimento e testes separadas, com resultado detalhado.
LLM gerenciado via AWS Bedrock, isolado por workspace, ou OpenAI, Gemini e Anthropic pelas suas conexões.
Conte o desafio da sua operação. Um especialista desenha com você o caminho entre o mapeamento e o primeiro robô rodando.